MapReduce 教程:分布式计算模型原理与实战要点
MapReduce 是 Hadoop 生态中负责批量数据计算的核心组件,它把复杂的分布式计算抽象为 Map 与 Reduce 两个阶段,让开发者无需关心任务调度、数据分片与容错细节即可处理海量数据。本页从编程模型、执行流程、调优策略到典型应用场景,为你梳理一条可落地的 MapReduce 学习路径。
一、MapReduce 编程模型速览
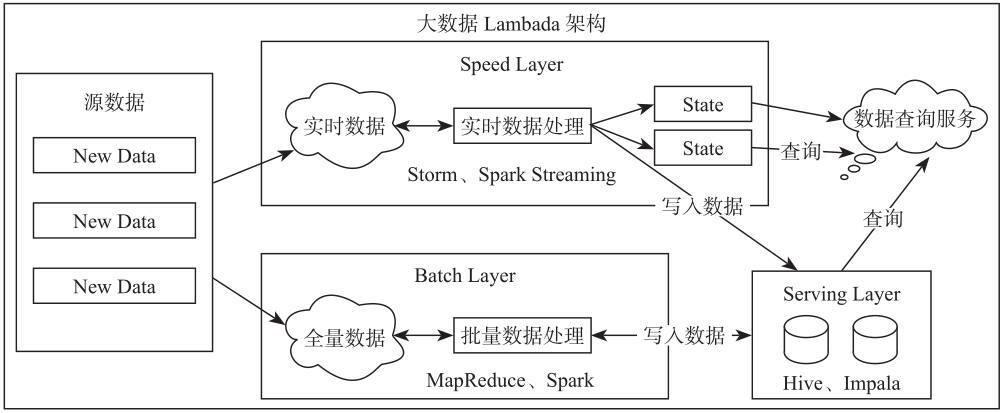
MapReduce 采用「分而治之」的思想:输入数据被切分为多个分片,每个分片交给一个 Map 任务并行处理,产出中间键值对;框架在 Shuffle 阶段按键对中间结果进行分区、排序与归并,再交由 Reduce 任务汇总输出。整个过程中,开发者只需实现 Mapper、Reducer 以及可选的 Partitioner、Combiner 等组件。
- Mapper:逐条读取分片记录,输出中间 key-value
- Combiner:在 Map 端做局部聚合,减少网络传输
- Partitioner:决定中间键落入哪个 Reduce 分区
- Reducer:对相同 key 的值集合进行归约计算
二、作业执行流程拆解
一个 MapReduce 作业从提交到完成,会经历资源申请、任务分发、数据本地化计算与结果落盘等多个环节。理解这条链路,是排查作业变慢、数据倾斜等问题的前提。
① 提交与分片
客户端计算输入分片并上传作业资源,JobSubmitter 向 ResourceManager 申请 ApplicationMaster。
② Map 与 Shuffle
Map 任务读取分片并输出中间结果,经环形缓冲区溢写、合并后由 Reduce 端拉取。
③ Reduce 与输出
Reduce 任务对归并后的数据执行用户逻辑,结果写入 HDFS,作业状态回写历史服务器。
三、关键配置与调优对照表
| 调优维度 | 常用参数 | 作用说明 |
|---|---|---|
| 分片大小 | mapreduce.input.fileinputformat.split.maxsize | 控制 Map 任务数量与单任务数据量 |
| 溢写与合并 | mapreduce.task.io.sort.mb | 影响 Map 端缓冲区大小与磁盘溢写次数 |
| Reduce 并行度 | mapreduce.job.reduces | 决定 Reduce 任务数量与输出文件个数 |
| 数据压缩 | mapreduce.map.output.compress | 降低 Shuffle 阶段网络与磁盘 IO 压力 |
四、典型应用场景与学习建议
适合 MapReduce 的任务
- 海量日志的离线清洗与统计
- 大规模文本的词频统计与倒排索引构建
- 数据仓库中的批量 ETL 与聚合计算
- 与 HDFS、Hive 配合完成底层批处理任务
推荐的学习顺序
- 先掌握 HDFS 的存储模型与读写流程
- 理解 MapReduce 的键值对抽象与执行阶段
- 动手编写 WordCount 并观察作业运行日志
- 再过渡到 Hive SQL 与 Spark 计算引擎
五、常见问题 FAQ
MapReduce 与 Spark 应该先学哪个?
建议先学 MapReduce 理解分布式计算的基本范式与 Shuffle 机制,再学习 Spark 的内存计算与 DAG 调度,两者对照学习效果更好。
作业运行很慢,优先排查什么?
先看是否存在数据倾斜,再检查分片数量是否过少、Shuffle 数据量是否过大,最后确认是否开启 Map 端聚合与中间结果压缩。
Reduce 数量可以随意设置吗?
不建议。Reduce 数量决定输出文件数与并行度,过多会产生大量小文件并增加调度开销,通常结合数据量与集群资源综合评估。
最新文章 / 相关阅读
继续系统学习大数据技术
从 HDFS 存储到 MapReduce 计算,再到 Hive 与 Spark,按路径循序渐进掌握核心组件。