Hive教程:从数据仓库基础到实战查询的完整学习路径
Hive 是构建在 Hadoop 之上的数据仓库工具,它将类 SQL 的 HiveQL 语句转换为 MapReduce 或 Tez 任务,让熟悉 SQL 的开发者能够低成本地处理 HDFS 上的海量数据。本页从 Hive 的定位与架构切入,逐步展开元数据管理、表类型、查询优化与常见问题,帮助你在实际数据仓库项目中快速落地 Hive 能力。
类 SQL 查询
用 HiveQL 表达数据加工逻辑,降低分布式编程门槛。
元数据驱动
通过 Metastore 统一管理库、表、分区与列信息。
批处理生态
与 HDFS、YARN、Spark 等组件协作完成离线数仓任务。
Hive 核心知识框架
学习 Hive 建议按“架构认知 → 表设计 → 查询开发 → 性能调优”的顺序推进。先理解 Hive 如何把 SQL 翻译成分布式作业,再掌握内部表、外部表与分区表的使用场景,最后结合执行计划与参数调优解决实际跑批问题。
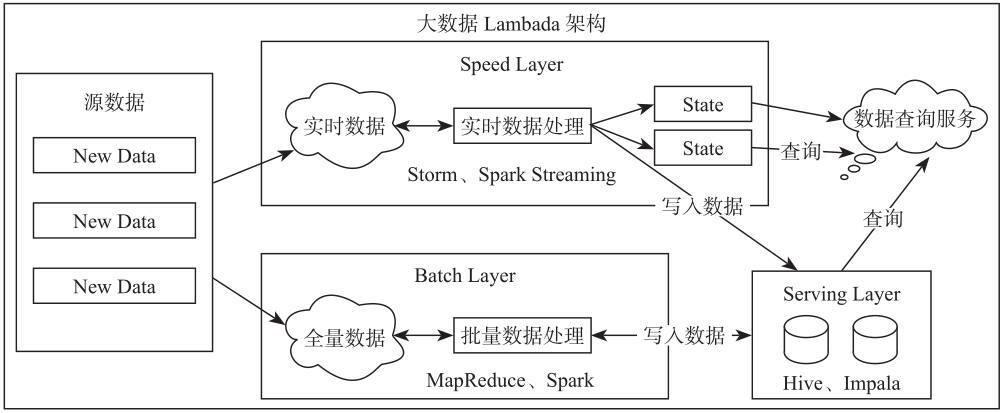
- 架构组成:Driver、Compiler、Metastore、Execution Engine 各自职责。
- 数据模型:Database、Table、Partition、Bucket 的层级关系。
- 表类型:内部表与外部表的删除行为差异及选型建议。
- 查询优化:分区裁剪、列裁剪、Join 策略与数据倾斜处理。
- 运维要点:小文件合并、元数据备份与权限管理。
Hive 学习阶段对照表
| 阶段 | 重点内容 | 建议产出 |
|---|---|---|
| 入门 | Hive 定位、安装模式、基础 DDL | 能创建库表并导入样例数据 |
| 进阶 | 分区表、分桶表、复杂数据类型 | 完成按日期分区的日志表设计 |
| 实战 | 多表 Join、窗口函数、调优参数 | 独立完成一个离线指标计算任务 |
常见问题 FAQ
Hive 和传统数据库有什么区别?
Hive 面向读多写少的离线批处理场景,不保证低延迟事务,适合海量数据仓库分析。
内部表和外部表怎么选?
需要 Hive 管理数据生命周期时用内部表;数据由外部系统写入或需保留原始文件时用外部表。
查询很慢从哪里入手排查?
先看执行计划是否发生分区裁剪,再检查 Join 是否产生数据倾斜,最后调整并行度与小文件策略。
实战场景速览
- ODS 层原始日志接入与分区设计
- DWD 层清洗去重与维度关联
- DWS 层轻度汇总与指标沉淀
- ADS 层结果表导出与可视化对接